DIY Technical SEO Audit: स्वतः करता येणारी 10-मुद्द्यांची चेकलिस्ट
उपयुक्त technical SEO audit दहा गोष्टी तपासते, आणि त्या याच क्रमाने: indexing, canonicals, sitemap, robots.txt, redirects, mobile rendering, वेग, internal links, structured data आणि duplicate content. यादीपेक्षा क्रम जास्त महत्त्वाचा आहे. बहुतेक audits वेगाच्या स्कोअरपासून सुरू होतात कारण ते काढणे सोपे असते, पण ज्या साइटमध्ये canonical ची चूक आहे तिला कोणालाच न सापडणारे पान अधिक वेगाने लोड झाल्याने काहीही फायदा होत नाही.
पहिल्या फेरीसाठी तुम्हाला सशुल्क crawler ची गरज नाही. Google Search Console, Screaming Frog सारख्या crawler ची मोफत आवृत्ती, PageSpeed Insights आणि तुमच्या ब्राउझरमधील view-source एवढे पुरेसे आहे; ज्या गोष्टींमुळे खरोखर ट्रॅफिक गमावला जातो त्यापैकी जवळजवळ सर्व काही यातून सापडते. पुढे हाच क्रम दिला आहे, आणि प्रत्येक टप्प्यावर काय पाहायचे व कशाकडे दुर्लक्ष करायचे तेही सांगितले आहे.
1. तुमचा कंटेंट खरोखर index झाला आहे का?
Search Console → Pages उघडा. index झालेल्या पानांची संख्या आणि तुम्ही प्रकाशित केली आहेत असे तुम्हाला वाटते त्या पानांची संख्या यांची तुलना करा. index झालेली पाने तुमच्या खऱ्या एकूण संख्येचा लहानसा भागच असतील, तर audit इथेच थांबवा आणि आधी ते दुरुस्त करा; ते सुटेपर्यंत या यादीतील दुसरे काहीही ट्रॅफिक आणणार नाही.
“Why pages aren’t indexed” खालील कारणे संख्येच्या क्रमाने वाचा. “Discovered – currently not indexed” चा अर्थ सहसा crawl-budget किंवा गुणवत्तेच्या संकेताची अडचण असा असतो. “Crawled – currently not indexed” म्हणजे Google ने पान पाहिले आणि ते साठवायचे नाही असे ठरवले. “Alternate page with proper canonical tag” बहुतेक वेळा ठीकच असते. “Excluded by noindex tag” एकतर बरोबर असते किंवा मोठे संकट असते, यादीत कोणती पाने आहेत त्यावर ते अवलंबून आहे — ते पानागणिक तपासा, कारण चुकून संपूर्ण साइटवर लागलेला noindex ही अशा मोजक्या चुकांपैकी एक आहे जी एका रात्रीत साइटचा ट्रॅफिक पुसून टाकू शकते.
सर्वात जास्त नुकसान करणाऱ्या दोन पॅटर्नचा नावानिशी उल्लेख करणे योग्य ठरेल. पहिला, साइट वेगळ्या hostname वर पुन्हा सुरू केली — www वरून non-www वर, किंवा http वरून https वर — पण Search Console अजूनही जुन्या property चाच अहवाल देत आहे. दुसरा, staging साइटचा noindex नियम production वर गेला. याचे निदान आम्ही crawled but currently not indexed या लेखात तपशीलवार मांडले आहे.
2. तुमचे canonical tags तुम्हाला वाटते तिकडेच निर्देश करतात का?
पाच पानांचा source पाहा — होमपेज, एक पोस्ट, एक category, एक tag archive आणि एक paginated पान — आणि rel="canonical" ही ओळ शोधा. प्रत्येक पानाने स्वतःकडेच निर्देश केला पाहिजे, आणि तोही तुम्हाला जसा index व्हायला हवा अगदी त्याच स्वरूपात: योग्य protocol, योग्य host, trailing-slash मध्ये विसंगती नाही, query strings नाहीत.
नेहमीचे अपयश म्हणजे एखाद्या plugin किंवा theme ची अशी सेटिंग जी प्रत्येक पानाचा canonical होमपेजकडे वळवते. हे क्वचितच घडते, पण घडले तर विनाशकारी असते, आणि source तपासेपर्यंत काहीच चुकले नाही असेच वाटते. ती दोन मिनिटे जरूर खर्च करा.
3. तुमचा sitemap लोड होतो का, आणि तो खरे सांगतो का?
तुमच्या sitemap index ची URL ब्राउझरमध्ये उघडा. तीन गोष्टींची खात्री करा: ती error किंवा HTML पानाऐवजी XML परत करते, आतील प्रत्येक URL तुमचा canonical hostname वापरते, आणि त्यात फक्त तीच पाने आहेत जी तुम्हाला index व्हायला हवी आहेत. noindex केलेली पाने, redirects किंवा 404s यांची यादी देणारा sitemap परस्परविरोधी सूचना पाठवतो आणि crawl budget वाया घालवतो.
WordPress ची एक लकब माहीत असावी: तुमचा SEO plugin स्पष्टपणे सक्रिय असताना त्याचा sitemap 404 देत असेल, तर त्याचे नेहमीचे कारण बिघडलेली सेटिंग नसून शिळे झालेले rewrite rules असते. Settings → Permalinks मध्ये जाऊन काहीही न बदलता save केल्यास ते पुन्हा तयार होतात आणि बहुतेक वेळा समस्या तिथल्या तिथे सुटते.
4. तुमची robots.txt काय अडवत आहे?
yourdomain.com/robots.txt लोड करा आणि प्रत्येक ओळ वाचा. अपेक्षेपेक्षा जास्त गोष्टी अडवणारे नियम तुम्ही शोधत आहात — Disallow: /wp-content/ मुळे Google तुमच्या CSS आणि images लोड करू शकणार नाही, आणि त्यामुळे ते तुमची पाने ज्या प्रकारे render करते ते बिघडते. तसेच तुमचा sitemap जाहीर केला आहे का हे तुम्ही तपासत आहात, आणि AI crawlers ना परवानगी द्यायची की नाही हे जाणीवपूर्वक ठरवत आहात.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://yourdomain.com/sitemap_index.xml
बहुतेक WordPress साइट्ससाठी ही एक पूर्ण आणि अचूक robots.txt आहे. तुमची फाइल याहून बरीच लांब असेल, तर जास्तीच्या ओळी काळजीपूर्वक वाचा — लांबलचक robots फाइल्समध्ये असे नियम साचत जातात जे कोणी जोडले हे कोणालाच आठवत नाही, आणि त्यातील प्रत्येक नियम म्हणजे तुम्हाला crawl व्हायला हवी असलेली एखादी गोष्ट अडवली जाण्याची शक्यता.
5. तुमचे redirects स्वच्छ आहेत का?
काही जुन्या URLs एखाद्या redirect checker ने तपासा आणि टप्प्यांची संख्या नोंदवा. प्रत्येक जास्तीचा टप्पा विलंब वाढवतो आणि, Google च्या स्वतःच्या मार्गदर्शनानुसार, तुम्ही पुढे पोहोचवू पाहत असलेले संकेत पातळ होण्याचा धोका निर्माण करतो. अनेक टप्प्यांच्या chains अंतिम ठिकाणाकडे जाणाऱ्या एकाच 301 मध्ये पुन्हा लिहा. redirect loops आहेत का तेही तपासा, तसेच स्थलांतर कायमचे असताना 302 वापरले आहे का ते पाहा — तात्पुरता redirect Google ला जुनी URL index मध्ये ठेवायला सांगतो.
6. मोबाइल आवृत्तीत सर्व काही आहे का?
Google तुमच्या साइटची मोबाइल आवृत्ती index करते. तुमचा मोबाइल template कंटेंट लपवत असेल, कधीच लोड न होणारे विभाग collapse करत असेल, structured data वगळत असेल किंवा desktop वर असलेले internal links गाळत असेल, तर Google च्या दृष्टीने तो कंटेंट अस्तित्वातच नाही.
याची नीट चाचणी करा: Search Console चे URL Inspection टूल वापरा, live test चालवा आणि rendered HTML टॅब उघडा. नुसत्या नजरेच्या तपासणीवर विश्वास ठेवण्याऐवजी तिथे प्रत्यक्षात काय आहे ते वाचा. त्यानंतर tap targets वापरण्याइतके मोठे आहेत याची खात्री करा — 15-पिक्सेलचा icon तांत्रिकदृष्ट्या उपस्थित असतो पण व्यवहारात निरुपयोगी असतो, आणि कोणी त्यांना SEO समस्या म्हणण्याच्या खूप आधी अशी अपयशे behaviour data मध्ये दिसू लागतात.
7. वेगाच्या कोणत्या आकड्यांमागे धावणे योग्य आहे?
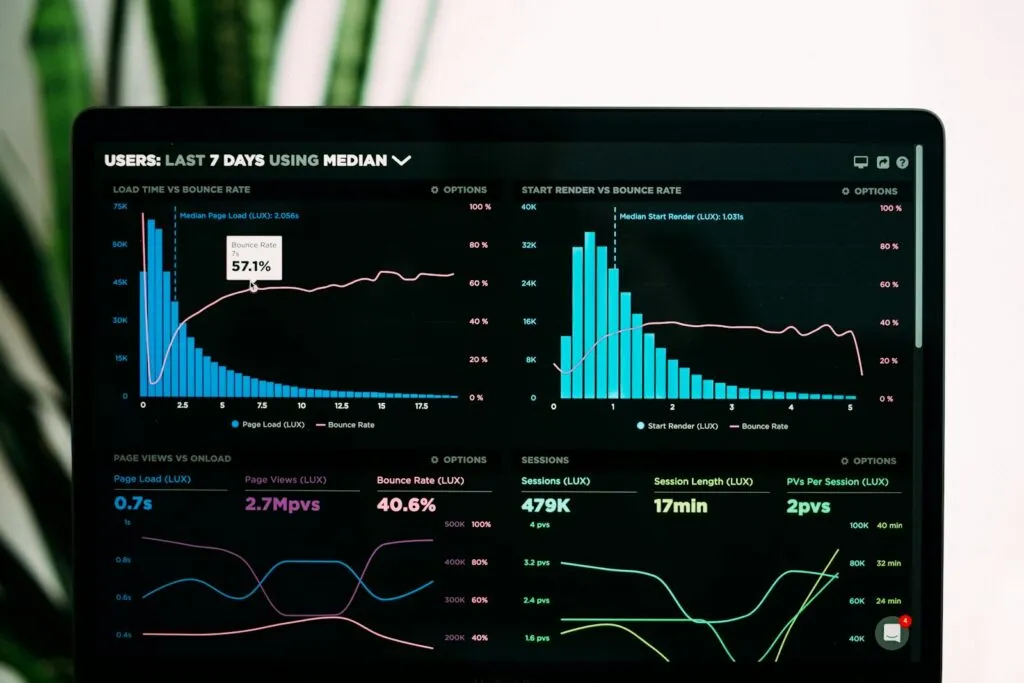
तुमच्या होमपेजवर आणि आतील दोन पानांवर PageSpeed Insights चालवा, आणि खालच्या lab score ऐवजी वरचा field data वाचा. Field data खऱ्या अभ्यागतांकडून येतो; lab score एका simulated device वरून येतो आणि प्रत्येक वेळी चालवताना बदलत राहतो. lab च्या आकड्यामागे धावणे हा technical SEO मधील श्रम वाया घालवण्याचा सर्वात सामान्य प्रकार आहे.
या तिन्हींपैकी प्रत्येकाचे एक अपेक्षित मुख्य कारण असते, त्यामुळे ते हाताळणे विलक्षण सोपे ठरते. संथ LCP चे कारण जवळजवळ नेहमीच optimise न केलेली मोठी hero image किंवा render-blocking stylesheet असते. खराब INP चे कारण जवळजवळ नेहमीच लोड होताना चालणारे अति JavaScript असते. Layout shift चे कारण जवळजवळ नेहमीच width आणि height जाहीर न केलेल्या images आणि जाहिराती असतात. स्कोअर नव्हे, कारण दुरुस्त करा.
8. प्रत्येक पानापर्यंत crawler पोहोचू शकतो का?
कोणत्याही crawler च्या मोफत आवृत्तीने तुमची साइट crawl करा आणि orphan पाने शोधा — म्हणजे तुमच्या sitemap मध्ये असलेल्या पण ज्यांच्याकडे एकही internal link निर्देश करत नाही अशा URLs. orphan पान Google ला फक्त sitemap मधूनच सापडू शकते, जो एक कमकुवत संकेत आहे, आणि ते जवळजवळ कधीच rank होत नाही. त्याचप्रमाणे तुमची click depth तपासा: होमपेजपासून तीनपेक्षा जास्त clicks दूर असलेली पाने कमी वेळा crawl होतात आणि कमी महत्त्वाची मानली जातात.
हे दुरुस्त करणे म्हणजे संपादनाचे काम आहे, engineering चे नाही: संबंधित जुन्या पोस्ट्समधून, category hubs मधून आणि तुमच्या सर्वाधिक पाहिल्या जाणाऱ्या पानांमधून links जोडा. संपूर्ण पद्धत आमच्या internal linking आणि साइट रचना या मार्गदर्शकात आहे.
9. तुमचा structured data वैध आहे का?
प्रत्येक template चे एक पान Rich Results Test मधून चालवा, नंतर Search Console → Enhancements उघडा. Warning म्हणून दाखवलेल्या कशाच्याही आधी Invalid म्हणून दाखवलेले सर्व काही दुरुस्त करा — warnings म्हणजे शिफारस केलेली fields गहाळ आहेत, तर errors म्हणजे markup टाकून दिला जात आहे. याचा तपशील आमच्या schema markup मार्गदर्शकात आहे.
10. तुमच्या साइटचा किती भाग duplicate आहे?
तुमचा crawl title tag नुसार sort करा आणि पुनरावृत्ती शोधा. अनेक URLs वर एकसारखी titles असणे याचा अर्थ सहसा tag archives, filter केलेली दृश्ये, session parameters किंवा paginated मालिका जवळपास duplicate पाने तयार करत आहेत. प्रत्येक गटासाठी निर्णय घ्या: त्याला noindex करा, एकाच आवृत्तीकडे canonical करा, किंवा तो parameter अडवा. काहीच न करणे हे एकमेव चुकीचे उत्तर आहे, कारण Google तुमच्यासाठी canonical निवडेल आणि ते तुम्हाला हवे तेच निवडेल असे नाही.
कशाकडे दुर्लक्ष करावे?
स्वयंचलित audit टूल्स शेकडो निष्कर्ष तयार करतात, आणि त्यातील बहुतेकांना काहीच महत्त्व नसते. ज्यांवर तुमची दुपार खर्च करू नये अशा गोष्टींची एक छोटी यादी: meta keywords, जे गेल्या दशकाहून अधिक काळ कोणत्याही search engine ने वापरलेले नाहीत; keyword density चे आकडे; परिपूर्ण 100 चा PageSpeed स्कोअर; खरोखर उपयुक्त navigation वर येणाऱ्या “too many internal links” च्या सूचना; सजावटीच्या images वर नसलेला alt text; आणि rendering वर परिणाम न करणाऱ्या W3C HTML validation errors.
400 समस्या दाखवणारे टूल त्याच्या स्वतःच्या मर्यादा दाखवत असते, तुमची प्राधान्ये नाही. वरील दहा टप्पे अशा समस्या व्यापतात ज्या खरोखर ट्रॅफिक दाबून ठेवतात. बाकी सर्व काही नीटनेटकेपणाचे काम आहे, जे महत्त्वाचे काहीच उरले नसताना करता येईल.
हे किती वेळा पुन्हा करावे?
स्थिर साइटसाठी दर तिमाहीला, आणि पुढील चारपैकी कोणतीही घटना घडल्यावर लगेच: theme बदलणे, migration किंवा hostname बदलणे, SEO किंवा caching शी संबंधित plugin update, आणि redesign. महिनोन्महिने लक्षात न येणाऱ्या बहुतेक तांत्रिक घसरणी याच चार गोष्टींमुळे होतात, कारण दृश्य बदलाकडे कोणी indexing चा धोका म्हणून पाहत नाही.
निष्कर्ष तारखेसह एका पानाच्या टिपणात जपून ठेवा: काय तपासले, काय सापडले, काय बदलले. याचे मूल्य वाढत जाते — पुढच्या तिमाहीत तुम्ही पुन्हा शून्यापासून सुरू करण्याऐवजी एका नोंदीशी तुलना कराल, आणि एकेकट्या audits मधून नेहमी निसटणारी संथ घसरण तुमच्या लक्षात येईल. याच कामाच्या कंटेंट बाजूसाठी महत्त्वाचे on-page SEO घटक आणि सोप्या टप्प्यांत समजावलेले SEO पाहा; धोरणाच्या स्तरासाठी GEO आणि AEO च्या युगातील ranking factors पाहा. अधिक माहिती आमच्या तंत्रज्ञान आणि digital marketing विभागात.
DIY technical SEO audit ला किती वेळ लागतो?
काही शेकड्यांपेक्षा कमी पानांच्या साइटसाठी दोन ते चार तास, जर तुम्ही वरील क्रम पाळला आणि गोष्टी सापडताच दुरुस्त करण्याचा मोह आवरला तर. आधी सर्व काही नोंदवा, मग प्राधान्यक्रमानुसार दुरुस्त करा. मोठ्या साइट्सना जास्त वेळ लागतो तो मुख्यतः crawl लाच जास्त वेळ लागतो म्हणून, पारखण्यासारखे जास्त असते म्हणून नव्हे.
पहिल्या audit साठी मला सशुल्क crawler ची गरज आहे का?
नाही. desktop crawler ची मोफत आवृत्ती काही शेकडो URLs पर्यंत हाताळते, जे बहुतेक लहान साइट्ससाठी पूर्णपणे पुरेसे आहे, आणि उरलेले Search Console व PageSpeed Insights सांभाळतात. सशुल्क टूल्स मोठ्या साइट्स, नियोजित monitoring आणि change tracking साठी उपयोगी पडतात, पण ती त्याच प्रकारच्या समस्या शोधतात.
कोणत्या तांत्रिक समस्येमुळे सर्वाधिक ट्रॅफिक गमावला जातो?
Indexing मधील अपयश, आणि तेही मोठ्या फरकाने. index न झालेले पान त्याचा वेग, markup किंवा कंटेंटची गुणवत्ता काहीही असली तरी काहीच मिळवत नाही. म्हणूनच indexing coverage हा पहिला टप्पा आहे, आणि तो भक्कम होईपर्यंत चेकलिस्टमधील पुढच्या कशालाही हात लावू नये.
टूलने दाखवलेली प्रत्येक समस्या मी दुरुस्त करावी का?
नाही. स्वयंचलित टूल्स सर्वसाधारण मर्यादांच्या आधारे अहवाल देतात आणि rankings वर काहीही परिणाम न करणाऱ्या गोष्टी नेहमीच दाखवतात, जसे की meta keywords, HTML validation च्या warnings किंवा सजावटीच्या images वरील alt text. त्याऐवजी प्राधान्यक्रमाने दिलेल्या दहा तपासण्या पूर्ण करा आणि उरलेल्या लांबलचक यादीला ऐच्छिक नीटनेटकेपणाचे काम समजा.
माझा PageSpeed स्कोअर 60 आहे. ही समस्या आहे का?
असेच असेल असे नाही. lab score हे एक simulation आहे जे प्रत्येक वेळी चालवताना बदलते; Google जे वापरते तो खऱ्या अभ्यागतांकडून आलेला field data असतो. तुमचा Core Web Vitals चा field data उत्तीर्ण होत असेल, तर मध्यम lab score मुळे तुमच्या rankings चे नुकसान होत नाही. अहवालाच्या वरच्या भागातील field विभाग वाचा, त्याखालील स्कोअर नव्हे.
Orphan पान म्हणजे काय आणि ते का महत्त्वाचे आहे?
Orphan पान म्हणजे अशी URL जी तुमच्या sitemap मध्ये दिसते पण जिच्याकडे एकही internal link निर्देश करत नाही. Google ला ते सापडू शकते, पण internal links नसल्यामुळे त्याला महत्त्वाचा जवळजवळ कोणताही संकेत मिळत नाही आणि ते क्वचितच rank होते. उपाय संपादकीय आहे: संबंधित जुन्या पोस्ट्समधून आणि त्याच्या category hub मधून त्याला link द्या.
Audit पुन्हा केव्हा करावे?
स्थिर साइटसाठी दर तिमाहीला, आणि theme बदलल्यावर, migration किंवा hostname बदलल्यावर, SEO किंवा caching plugin update नंतर, किंवा redesign नंतर लगेच. लक्षात न येणाऱ्या बहुतेक तांत्रिक घसरणी याच चार घटनांमुळे होतात, कारण निव्वळ दृश्य वाटणारा बदल indexing चे वर्तन बदलू शकतो.